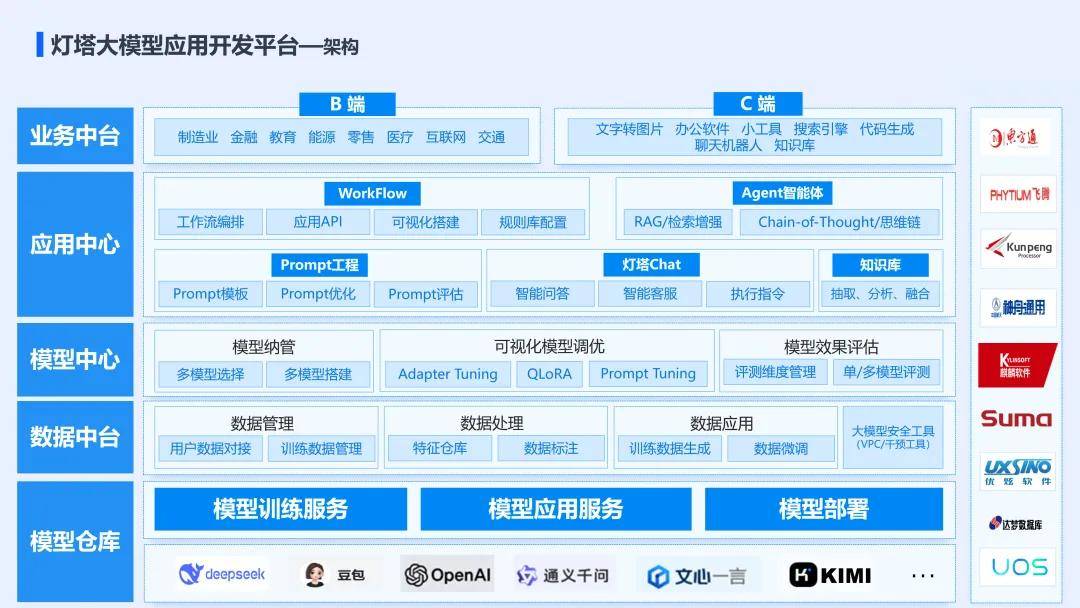
2024年以来,国内大模型产业的重心正从"参数竞赛"转向"场景落地"。据中国信息通信研究院《人工智能白皮书》数据,2023年我国人工智能核心产业规模已达5784亿元,其中企业级大模型应用占比从年初的12%攀升至年末的31%。在这一转型过程中,达个客大模型凭借对行业场景的深度适配能力,为信息传输、软件和信息技术服务业的智能化升级提供了一条可复用的技术路径。
一、从通用能力到行业纵深:大模型开发的分层逻辑
通用大模型在开放域对话中表现优异,但进入企业生产环境后,往往面临术语理解偏差、业务规则缺失、输出不可控等问题。达个客大模型的解决思路是"基座能力+行业增量"的分层架构:底层复用成熟的开源基座,中间层通过行业语料进行持续预训练与指令微调,上层以插件化方式接入企业知识库和业务系统。
这种分层设计的好处在于成本可控。以某省级电信运营商的实际部署为例,其客服工单分类场景在引入行业大模型训练后,意图识别准确率从规则引擎时代的76%提升至91.3%,同时单次推理成本较调用通用API下降约四成。这说明行业大模型的价值不在于"更大",而在于"更准"。
二、智能问答系统的工程化挑战
智能问答是企业对大模型最直观的需求,但真正决定体验的往往是检索增强生成(RAG)链路的工程质量。达个客大模型在多个项目中沉淀出一套实践方法:文档切分粒度需结合业务语义而非固定字数,向量检索与关键词检索应做混合召回,生成环节则要设置置信度阈值以触发人工兜底。
- 知识更新机制:企业制度、产品参数变动频繁,需建立增量索引管道,避免全量重建带来的延迟;
- 多轮上下文管理:在工单、售后等场景中,对话状态需与业务系统字段对齐,而非仅依赖模型记忆;
- 评估体系:以人工抽检结合自动化指标(如答案忠实度、拒答率)持续监控效果衰减。
三、私有化部署与API接口的取舍
金融、政务、医疗等行业对数据出域高度敏感,大模型私有化部署因而成为刚需。达个客大模型支持在国产化算力平台上完成推理部署,通过模型量化与显存优化,使70亿参数级别的模型可在单卡环境中稳定运行。与此同时,对于数据敏感度较低、追求快速验证的场景,大模型API接口提供了按量计费的轻量接入方式,企业可在两周内完成从测试到上线的闭环。
值得关注的是,桑日县等县域市场的人工智能需求正在萌发。基层政务咨询、农牧业技术问答等场景对模型的多语言能力和低资源环境适应性提出了特殊要求,这也倒逼AI模型定制服务向更细分的区域化、本地化方向演进。
四、结语
企业级大模型的竞争,最终落在"能否稳定交付业务价值"这一朴素标准上。达个客大模型的实践表明,大模型开发不是一次性采购,而是包含数据治理、系统集成、持续运维的长期工程。对于信息技术服务企业而言,把模型能力嵌入现有软件与系统集成体系,或许比追逐榜单排名更具现实意义。